⏳ This skill is pending AI review.
Scores will appear once the review pipeline completes.
jobradar
查询中国公司(含大厂与招聘平台上的公司)当前在招的校招/实习/社招岗位、近期新开/下架变化、岗位要求对比和招聘趋势。用户问"某公司在招什么岗位""这周新开了什么岗""A 和 B 的某类岗位要求有什么差异""某公司招聘是在扩张还是收缩"时使用。数据包含官方招聘页与公开聚合来源,每日调度,本地查询,单源新鲜度以返回时间为准。
Choose how to use this skill
You do not need every option. Choose the path your AI client supports. The stable page stays the same; versioned files are immutable.
1. Native installer
This listing has no registered native installer command. Use the complete package or source fallback below, depending on what your client supports.
Do not guess an installer command or replace an existing version without reviewing the diff.
2. Complete package recommended
Download the ZIP when available. It includes SKILL.md plus the references, security notes and version metadata.
No complete ProSkills package is published for this listing yet.3. Prompt-only
Copy the prompt above when the agent can read the stable page or when you want to adopt the workflow without installing a skill.
Need only the instruction file?
Download SKILL.md only if your client requires a single file. The complete ZIP is safer for a full installation because it preserves the references and release context.
No path installs or executes anything by itself. Your agent still needs access to the project files. Before updating, compare the installed version and review the diff.
// RATINGS
Not yet listed on ClawHub or SkillsMP
// README
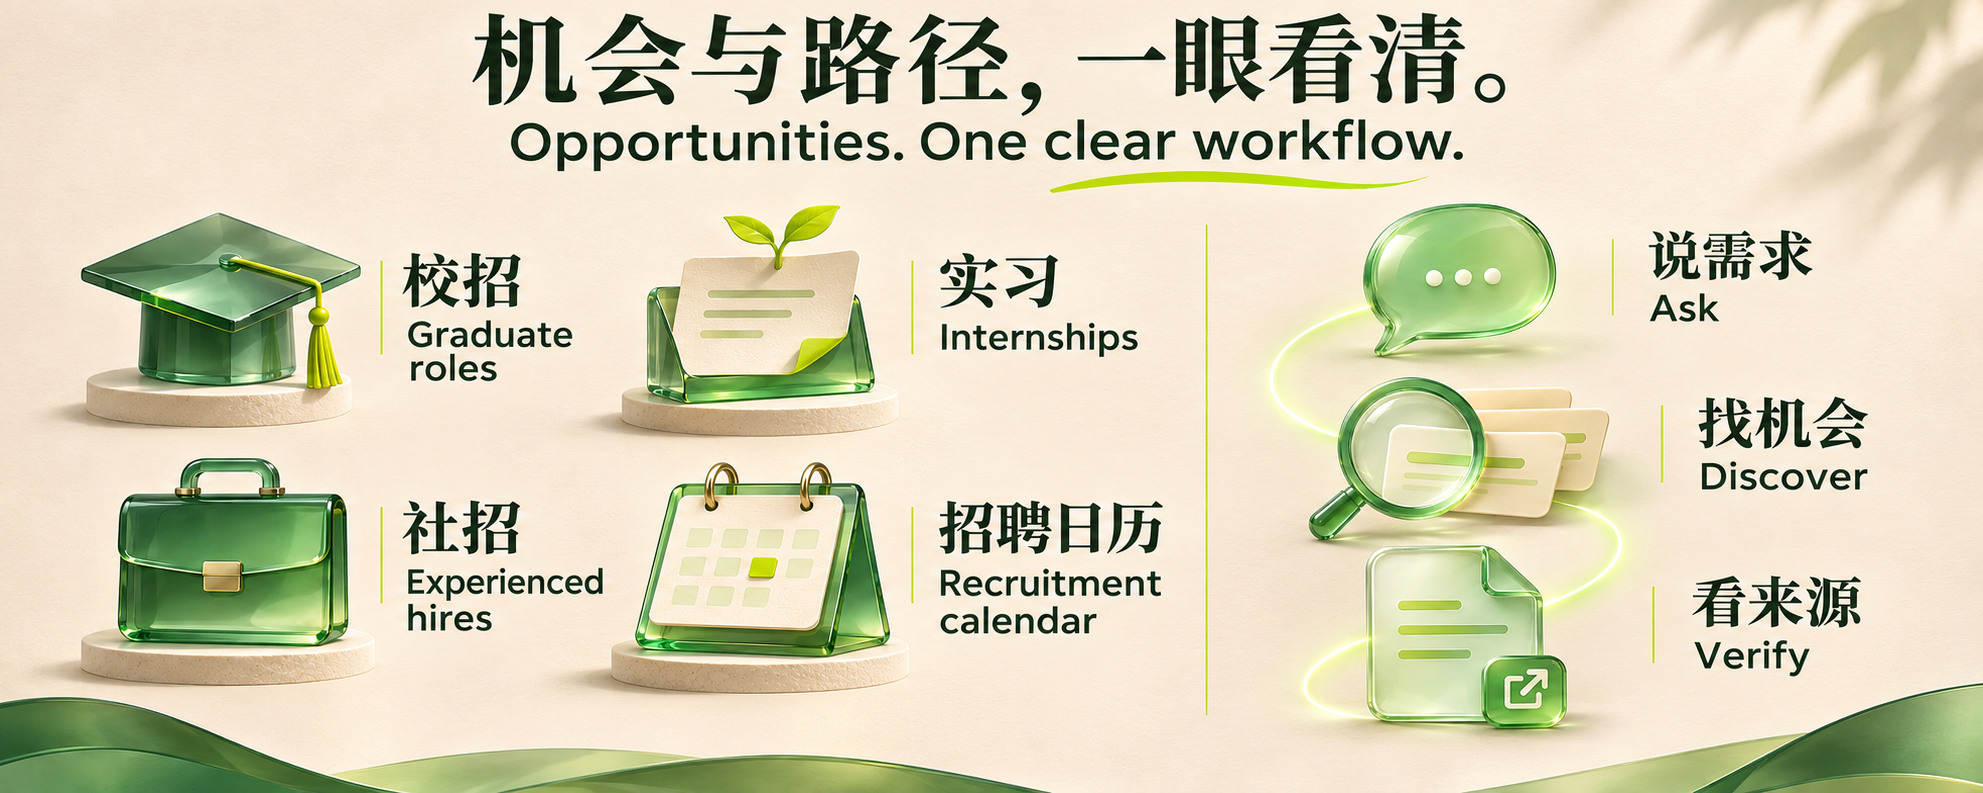
给你常用的 AI 助手,加一个找工作的技能。
你说想去哪里、做什么、有什么条件,助手帮你查中国校招、实习、社招与招聘日历,读岗位要求,再把候选和来源链接整理给你。适合应届生、在校实习生和寻找社招机会的求职者。
推荐通过 Agent 平台的技能或 MCP 接入,日常使用直接聊需求。 WorkBuddy、千问办公可从技能导入开始;Kimi 的本地 Agent 模式、Claude Desktop、ChatGPT 等按客户端能力选择接入路径。扣子、智谱清言等平台的适用条件见平台说明。首次按平台提示准备工具和数据,之后不用记命令或参数。
你可以这样问
“苏州、无锡都可以,帮我找财务校招;排除上海,把2027届明确匹配和届次没写的分开。”
“帮我比较这几个岗位的学历要求,字段与正文有冲突的请指出依据。”
“看看招聘日历里哪些项目有明确网申窗口,哪些还需要去官网确认。”
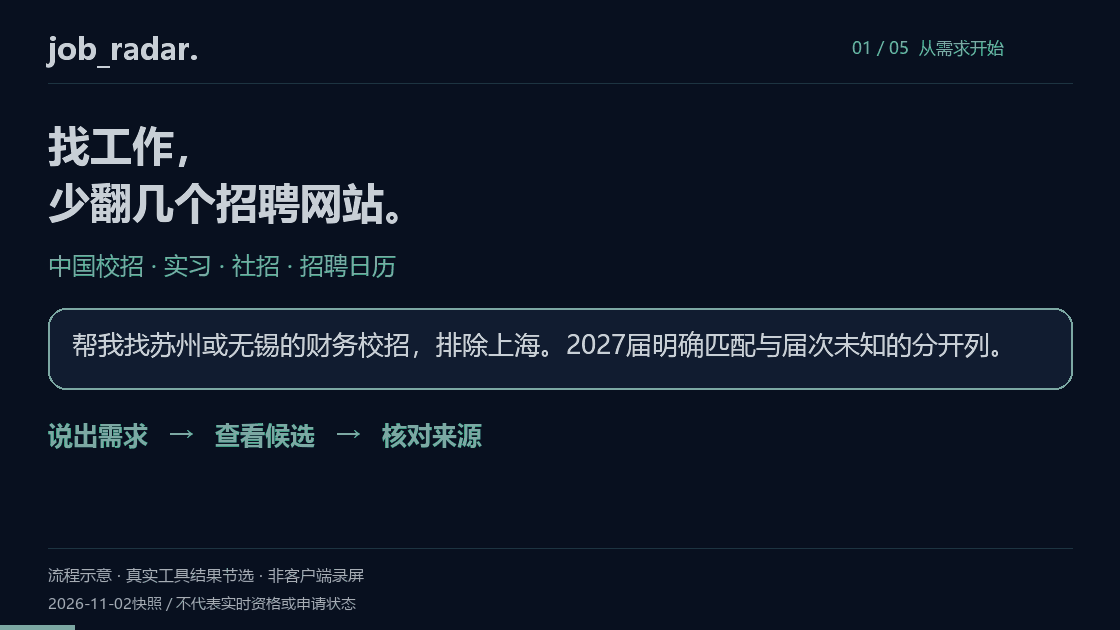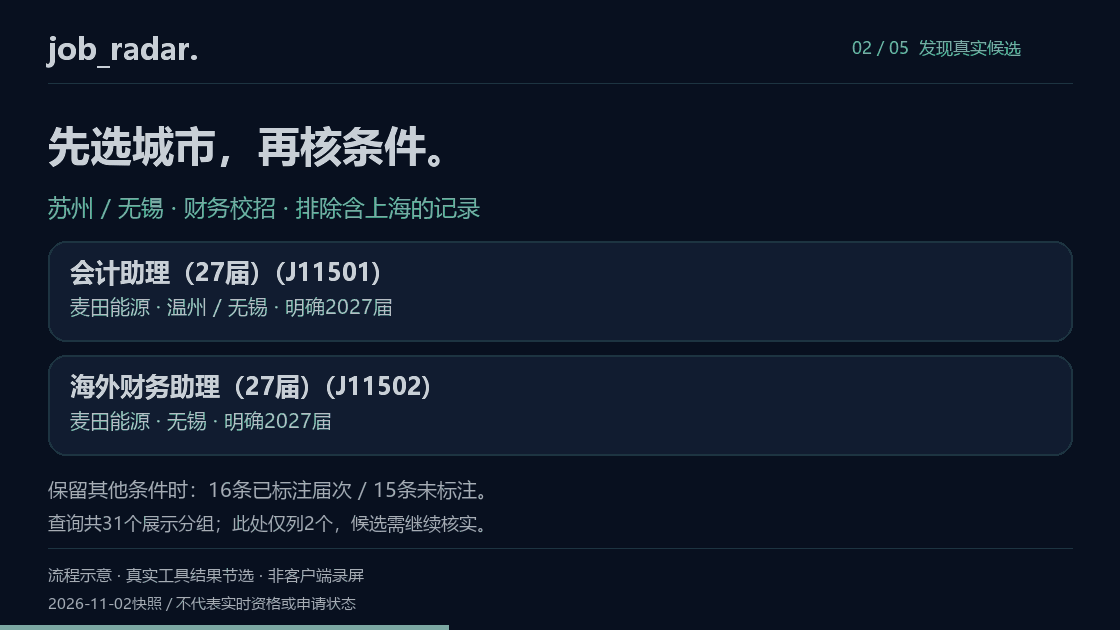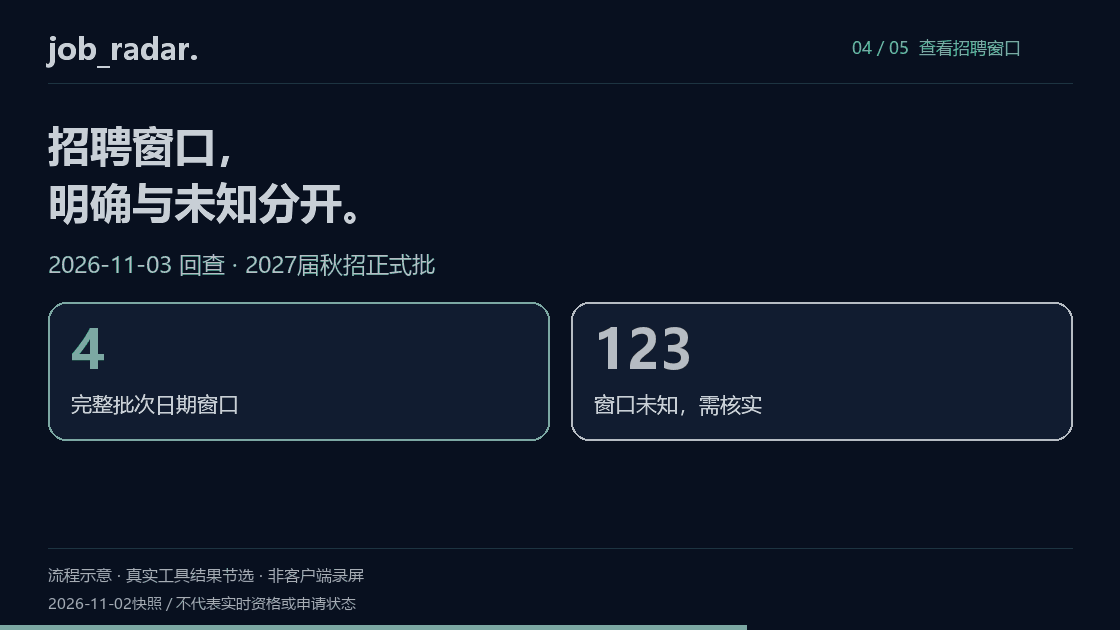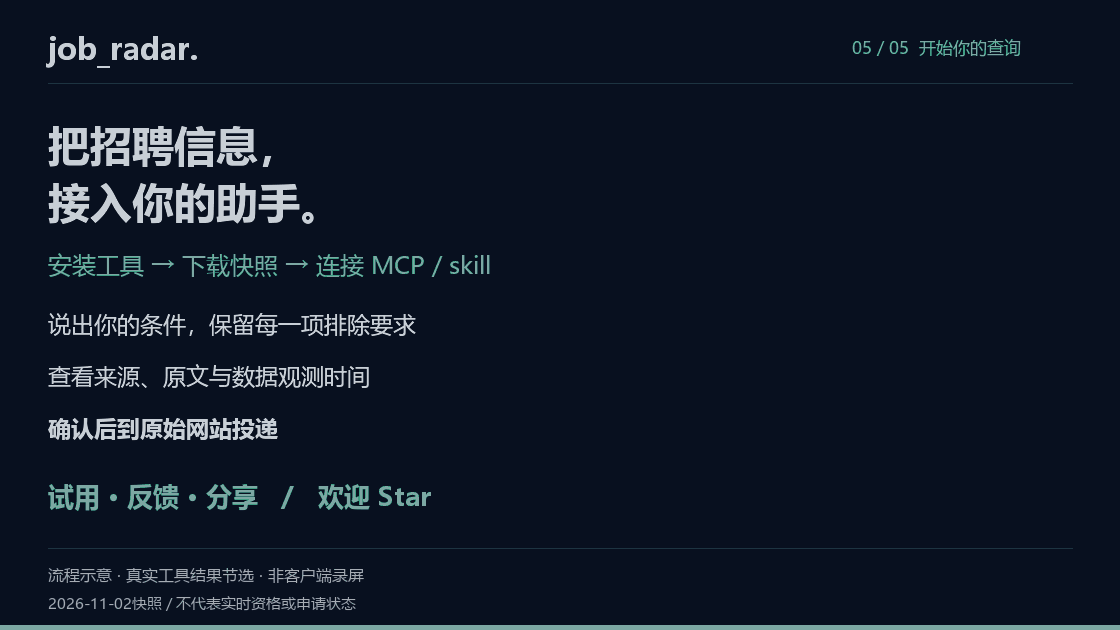
流程示意采用实际工具返回的结果节选,非第三方客户端录屏。原始数据时间与演示范围见素材说明;播放节奏不代表查询耗时,候选不等于资格已确认。
为什么用 job_radar
| 你想做的事 | 项目提供的能力 |
|---|---|
| 找到适合自己的岗位 | 多城市并集,排除城市、公司和标题词;按招聘类型、职类与毕业年份组合筛选 |
| 阅读真正的岗位要求 | 搜索标题与 JD 原文,保留原始招聘链接 |
| 跟上招聘节奏 | 招聘日历、网申窗口,以及开岗 / 变更 / 下架历史 |
| 沿用熟悉的助手 | 完成首次接入后,用自然语言提问、补充条件和比较候选 |
| 减少重复翻找 | 在同一工作流中查询岗位、原始要求、近期变化与招聘日历 |
| 判断信息是否可靠 | 官方与聚合来源分开标注,提示字段缺失与学历冲突,统计可复算 |
快速开始
代码包与招聘数据分开下载。正文采用无损精简存储,默认自动清理无读者的旧快照;全部岗位关联和观测时间保留。下载与空间说明。
1. 打开你常用助手中支持技能或本地工具的 Agent 工作模式。 不确定选哪个?先看平台接入说明。
2. 把这段话发给它,跟随平台提示完成首次接入。
请帮我接入这个仓库里的 jobradar 求职搜索技能:
https://github.com/lijiaqi-AI-Product-Manager/job_radar
先阅读接入说明,检查当前平台是否支持;完成后,帮我找上海的产品实习,列
出岗位要求、来源链接和已注明的截止日期,没写清的信息单独说明。
需要上传文件时,从当前代码 Release下载 jobradar-skill.zip,或导入仓库的 skill/jobradar 文件夹。技能包内有助手需要的准备步骤;导入说明后仍需安装查询工具和下载数据。
3. 之后直接说需求,也可以继续追问。
“换成深圳,还是产品实习。把没写截止日期的单独列出来。”
成功接入后,助手应实际查询并给出候选、来源链接和数据时间。普通网页聊天或只接受远程服务地址的模式可能需要换用兼容入口;不能只凭读过仓库介绍就当作已经接入。完整首次使用指南中有说明。
Skill 是助手的求职查询说明,MCP 是它调用工具的连接方式,选平台支持的一种即可。查询工具不需要单独的 API key;你使用的助手可能按其套餐收费。项目不要求上传简历,不代投。
需要 Python 3.11+,支持 Windows、macOS 和 Linux:
python -m pip install --upgrade "jobsearchradar[mcp]"
jobradar update
jobradar doctor
在兼容客户端添加本地 stdio 服务,具体顶层字段以客户端界面为准:
{
  "mcpServers": {
    "jobradar": {
      "command": "jobradar-mcp"
    }
  }
}
客户端需能找到安装环境里的可执行文件,找不到时使用其绝对路径。自定义数据目录时,在服务 env 中设置同一 JOBRADAR_HOME。技能路径也可按查询工作流直接调用本地工具,无需同时配置 MCP。
包名为 jobsearchradar,命令为 jobradar / jobradar-mcp。首次更新需联网下载岗位、正文与日历三库,需预留下载和解压空间;下载后本地查询可离线使用。后续让助手检查并更新快照;默认目录为 ~/.cache/jobradar。只用终端可安装 jobsearchradar。
当前推荐默认的 GitHub 数据渠道;Gitee 与 npm 的核查状态见安装渠道。安装与排错提供环境检查和固定源码备用方式。
查询示例
日常使用可直接说“找上海算法实习”“看看这周新开的岗位”“对比这几家公司的要求”。下面的命令供助手和终端使用者参考。
按条件找岗位
# 公司 + 招聘类型 + 届次
jobradar search --company 复星医药 --type campus --grad-year 2027 --limit 3 --table

# 搜索标题与 JD 正文,多个词共同匹配
jobradar search --text "PyTorch 大模型" --type campus --limit 3 --table

# 城市、职类与去重
jobradar search --city 上海 --category 算法 --type intern --dedupe --table

# 可选城市取并集,排除含上海的多城市记录
jobradar search --cities 苏州 无锡 --exclude-city 上海 --category 财务 --table
查看日历与最近变化
jobradar calendar --group 阿里巴巴 --grad-year 2027 --table
jobradar diff --days 7 --types open --table
jobradar diff --days 7 --by category --company 腾讯
jobradar trends 美团 --step-days 7
省略 --table 即输出 JSON,便于脚本处理。用 jobradar show <job_id> 查看单岗详情与 JD;用 jobradar doctor 检查本地数据状态。更多参数见 jobradar --help 与 字段说明。
明确截止日过后,岗位会按北京时间自动退出默认搜索;历史记录保留,日期未知不推定过期。来源健康摘要与搜索使用相同的在招口径。
每条候选会区分来源刷新与岗位自身的观测;本轮未再次见到的岗位保留为待核实历史记录。
CLI / MCP 默认折叠相同展示分组,variants 保留原条数;查看全部记录用 --no-dedupe。
按届次或截止日筛选时,即使有结果也会提示未标注字段的范围。未知候选与明确匹配分别说明,不能把关键词命中当作资格保证。详见个人条件查询。
助手可以调用哪些能力
提供搜索、单岗详情、近期变化、职类新增、公司对比、趋势、数据状态、招聘日历和统计 9 个工具。技能与 MCP 两种接入方式共用查询规则;首次接入见快速开始。
薪资、经验、每周实习天数和远程等精细条件需要读取详情逐条核实,不能将全文词语命中直接写成“满足要求”。缺失日期和资格条件会保留未知。更多示例见个人条件查询。
数据与覆盖
配置统计 · 2026-11-14
| 指标 | 当前值 | 含义 |
|---|---|---|
| 启用数据源 | 2,230 | 启用的源配置 |
| 配置公司 | 2,199 | 启用源对应的去重公司 |
| 采集适配器 | 27 | 共享平台与自研站适配器 |
| 核心目标覆盖 | 944 / 1,655 · 57.04% | 固定目标池中的配置覆盖 |
| 其中官方 / 聚合 | 598 / 346 | 优先按官方归类,不重复计数 |
已核验发布快照 · 2026-11-14T00:19:59Z
共 354,560 条岗位记录,其中 320,124 条可见记录;对应 JD 正文覆盖率 97.6%。招聘日历样本共 5,617 条,含 2,078 条人工整理条目。这是有日期的历史快照,实时规模以本地 jobradar stats 和最新 [数据 Release](https://github.com/lijiaqi-AI-Produ
// HOW IT'S BUILT
// FILES
6 files shipped with this skill. Inline text is the catalog copy. The upstream link is the source repository.
skill/jobradar/SKILL.md16 KB440049752b2bupstream ↗
--- name: jobradar description: 查询中国公司(含大厂与招聘平台上的公司)当前在招的校招/实习/社招岗位、近期新开/下架变化、岗位要求对比和招聘趋势。用户问"某公司在招什么岗位""这周新开了什么岗""A 和 B 的某类岗位要求有什么差异""某公司招聘是在扩张还是收缩"时使用。数据包含官方招聘页与公开聚合来源,每日调度,本地查询,单源新鲜度以返回时间为准。 --- # jobradar:对话式求职搜索技能 用户通过对话提出求职需求,宿主优先调用已连接的 MCP 工具;未连接时可使用 `jobradar` 的 JSON 输出。 两者共用查询规则。**只能根据工具返回的数据回答,不能用常识或记忆补充岗位信息,也不要要求求职者理解命令行参数。** ## 首次接入 用户要求安装、导入或接入本技能时,先阅读 [首次准备](references/setup.md),检查当前平台能否执行本地工具或连接本地 MCP,再准备工具和数据并实际查询。未调用成功前不要声称已接入;只阅读了技能或仓库不等于已经具备查询能力。 已有可用 MCP 时优先使用其工具,无需要求用户再安装另一套入口。求职者只需说需求,配置细节由助手处理;需要界面操作时给出当前一步即可。 ## 安装或升级(首次使用或参数不受支持时) 最低已验证兼容基线为 `2.3.1`;默认升级至当前正式版,再核对版本和功能参数。正式渠道核验状态见安装指南: ```bash pip install --upgrade "jobsearchradar[mcp]" jobradar --version jobradar search --help jobradar calendar --help ``` 发行包经过独立安装与命令兼容性检查,实际安装后仍须核对版本和参数。固定源码备用安装及版本说明见 [安装指南](https://github.com/lijiaqi-AI-Product-Manager/job_radar/blob/main/docs/INSTALLATION.md)。已安装旧版也用上述命令升级, 不要仅因本机已有 `jobradar` 命令就跳过版本兼容检查。帮助中应有 `calendar --city`、 `calendar --include-expired` 与 `search --deadline-before`;旧版帮助报错或不支持参数时, 先在 CLI / MCP 实际使用的环境中升级,不能通过删掉筛选参数来改变用户的问题。 ## 第一步:检查数据(每次会话第一次使用时) ```bash jobradar doctor ``` - 没有数据,或`snapshot_stale: true` → 先运行`jobradar update`(同时下载岗位库与JD原文库),再继续。若`snapshot_stale: false`而`stale: true`,说明返回岗位或来源陈旧,需核实原始链接,不能反复下载相同快照代替核实;旧版未返回`snapshot_stale`时核对`data_as_of`再决定是否更新。 - `source_health.counts.stale > 0` → 部分来源超过 48 小时未成功刷新,整体快照较新也不能证明这些岗位仍在招。用 `jobradar sources --problems` 查看;提及受影响岗位时注明 `last_seen`,建议打开原链接确认。更新快照不能保证来源已恢复。 - 岗位 `source_stale: true` 或 `availability: unconfirmed_stale` → 表述为历史观测岗位,不能断言当前可投;注明 `source_last_ok`。`observed_recently` 也只表示最近采集成功,投递仍以原站为准。 - `source_enabled: false` 或 `availability: unconfirmed_disabled` → 来源当前已停用;即使旧成功观测尚不足48小时,也不能表述为当前已核实可投。停用不等于岗位已关闭。 - 展示 `availability_label` 和 `source_warnings` 对当前可投状态的限制。`source_tenant_peers` 非空表示同一招聘租户还登记在其他来源下,岗位可能重复;不要跨来源相加,也不要据此擅自更改雇主归属。 - 来源最近刷新不等于岗位再次出现。`availability=unconfirmed_not_seen` / `not_seen_in_latest_success=true` 表示该岗位在最新成功采集中未再次见到,只能作为待核实历史候选;不能说当前可投,也不能直接说已下架。看岗位自己的`last_seen` / `job_age_hours`,`availability_counts`仅统计本次返回记录。 - 明确指定校招/实习时,搜索与对比默认过滤标题明确的一线门店和房产经纪岗位。用户明确寻找此类岗位时传`include_frontline=true`(CLI `--include-frontline`);不限类型与社招不默认过滤。说明`frontline_filter`的模式和计数,全文检索计数为`null`时不能编造。`exclude_categories`是字段排除,未知职类需修正,空字段仍需原文核实。 - 下载使用默认 GitHub 渠道;失败时先检查网络和数据状态,不将当前未核实可用的镜像作为首选。见[渠道状态](https://github.com/lijiaqi-AI-Product-Manager/job_radar/blob/main/docs/DISTRIBUTION.md)。 - `record_kind: recruitment_notice` 是招聘公告,可能包含多个职位,不能将公告条数表述为岗位数;`source_kind: aggregator` 是公开聚合来源,引用时说明来源。`unknown` 不能按名称猜测。详情中的 `source.compliance_checked_on` 是配置的合规核查日期,不代表今天已成功读取。`stats` 的 `by_record_kind` 与 `by_source_kind` 提供分层计数。 - 默认搜索和日历按北京时间自动隐藏明确截止日已过的记录,截止当天仍保留;查历史岗位用 `search --include-closed`,查历史日历用 `calendar --include-expired`(MCP 对应 `include_closed` / `include_expired`)。`calendar --open-on` 以指定日期为准。不要通过补填未知日期来让条目过期。 - 数据目录不是默认的 `~/.cache/jobradar` 时,给 MCP 配置的 `env` 传 `JOBRADAR_HOME`。 ## 按个人条件找机会 用户提出多城市、排除公司、学历/经验要求、实习安排或连续修改条件时,参见 [个人求职条件与连续追问](references/candidate-workflow.md)。该流程区分可直接筛选的条件、 需要阅读原文的要求,以及尚未核实的资格;放宽条件后的结果必须单列。 ## 按问题类型选命令 | 用户在问 | 命令 | |---|---| | 某公司/城市/职类在招什么 | `jobradar search --company 复星医药 --category 医药研发 --city 上海 --type campus --grad-year 2027 --limit 20` | | 标题关键词 | `jobradar search --keyword 大模型` | | 用户明确希望查门店实习 | `jobradar search --type intern --include-frontline --keyword 门店 --limit 20` | | 按技能/要求找岗位(JD 原文里出现的词) | `jobradar search --text "PyTorch 多模态" --type campus --limit 20`(空格分隔的词须全部出现;结果的 `match` 是命中处原文片段) | | 某个岗位详情、要求 | `jobradar show <job_id>` | | 这周/最近新开、下架、变化 | `jobradar diff --days 7 --company 腾讯 --types open` | | 最近哪类职位新增最多 | `jobradar diff --days 7 --by category`(返回 `[{category, n}]`,按数量降序;没职类的归「未分类」) | | 两家或多家公司同类岗位要求对比 | `jobradar compare 药明康德 正大天晴 --keyword 研发 --per-company 5`;按职类用 `--category 医药研发`,按 JD 原文(如「论文」)用 `--text 论文` | | 招聘规模趋势 | `jobradar trends 腾讯 --step-days 7` | | 某公司有哪些招聘项目/批次、网申什么时候截止、去哪投(**含目前只有日历、没有岗位数据的大厂**) | `jobradar calendar --group 字节跳动 --grad-year 2027` | | 现在还能投哪些 | `jobradar calendar --type 秋招正式批 --open-on <今天日期>` | | 快截止的岗位(按网申截止日) | `jobradar search --deadline-before <本月末> --type campus`;日历同理用 `jobradar calendar --deadline-before <日期>` | | 某城市有哪些校招 | `jobradar calendar --city 北京` / `jobradar search --city 北京` | | 哪些公司写了网申起止 / 招哪些方向 | `jobradar calendar --has-window` / `jobradar calendar --has-tracks` | | 覆盖了哪些公司 | `jobradar stats` | | 数据什么时候更新、哪些源有问题 | `jobradar sources` | 参数说明:`--type` 取 `campus`(校招) / `intern`(实习) / `social`(社招);`--company` 先按**公司名全等**匹配,再查简称映射表(如 `中核`→中国核工业集团、`国寿`→中国人寿,见 `taxonomy/company_aliases.yaml`),最后只在命中唯一一家时用子串兜底(`阿里`→阿里巴巴)。**没把握就不猜**:`--company 京东` 不会返回「京东方」,而是 0 条 + 提示 `company_match.match = none`;命中多家时 `match = ambiguous` 并给出候选。要看 `company_match` 再回答(见回答规则 4)。`--contains` 才强制子串搜索(如 `--company 中国` 一次看所有含「中国」的公司)。`--category` 同时匹配大类与子类(如 技术、算法、后端、芯片/硬件、产品经理),可选值见 `references/fields.md`。**职类按标题规则归类,部分岗位为空**:`--category` 无结果时,再用 `--keyword` 按标题关键词查一次(如 `--keyword 研发`),仍无结果再用 `--text` 在 JD 原文里查,三者都无结果也只能说当前数据中未找到匹配记录。 ## 回答规则(必须遵守) 1. **注明数据时间**:回答开头或结尾写"数据截至 {data_as_of}"。`stale: true` 时明确提醒数据可能过期。 2. **附链接**:列出的每个岗位都附 `url`,引导用户去官网查看和投递。 3. **只用返回的数据**:没查到就说没查到。不编造岗位、薪资、面试难度、往年数据、HC 数量。 4. **查不到时说清楚是哪种情况**: - 只有公司匹配为 `none`,或 `compare` 的 `missing_companies` 里有它,才说明公司未收录;筛选后 `results` 为空或旧字段 `not_found` 不能证明未收录,更不能说"这家公司没在招"。 - **先看 `company_match`**(`search`/`diff`/`trends` 都带):`match: none` = 这个名字在数据集中不存在(`candidates` 是相近的公司,可以顺势提示"你要找的是不是 X");`match: ambiguous` = 命中多家、故意不返回;`match: contains` = 按子串唯一命中(如 阿里→阿里巴巴);`exact`/`alias` = 确定是这家。**`none`/`ambiguous` 时不能说"该公司没在招"**。 - 岗位 `closed_at` 有值 → "该岗位已于 {closed_at} 下架"。 - 字段为空(如北森门户的 `cities` 为空列表)→ 说明"数据中未提供该信息",不要从标题或常识推断。 - **有结果也可能漏掉字段为空的岗位**:每次阅读 `filter_coverage` 和 `hints`,说明未标注届次或截止日的范围,不能只在空结果时检查。需要保留未知届次候选时使用 `include_unknown_grad_year=true`;这些记录的 `grad_year_match=unknown` 仍待核实。统计中的 `unit=records` 未做展示折叠,不能与分组总数直接比较。正文检索未复算放宽后的数量时如实说明,不编造漏岗数。 - 某公司未收录或只覆盖了部分招聘类型:`jobradar sources` 可看各源;不要因为没查到就说"该公司没有校招",应说"数据里没有"。 **字节跳动、蔚来、小鹏汽车、Momenta 已收录**(同为飞书招聘 ATSX 门户,2026-10-26 起,见 `docs/recon/feishu-atsx.md`), 是否有匹配岗位、城市与 JD 是否完整,都以本次返回为准,不能凭历史样本承诺 100%。 5. **变化类问题用 `diff`/`trends`**,不要拿两次 `search` 结果自己比。说明覆盖的时间跨度;历史不足时如实说(例如"数据从 X 日开始积累")。 6. **对比类问题**:只依据 `compare` 返回的 `requirements`/`description` 原文;区分"JD 原文写的"与"你的归纳",引用关键原句。`requirements` 为 `null` 但 `description` 有内容时仍可读取正文;只有两者均为空才说明缺少 JD 原文。样本有限时(如每家只有 2–3 个岗位)提醒结论的代表性有限。`missing_companies` 才表示公司未收录;`no_matching_jobs` 表示已收录但没有符合本次条件的岗位;`ambiguous_companies` 需先澄清公司名。旧字段 `not_found` 仅汇总空结果,不能当成未收录清单。对比支持统一城市、招聘类型与届次筛选,不得在空结果时偷偷放宽条件。 7. **招聘日历(`calendar`)**: - 每条都有 `source`(来源名称、链接、发布日期)与 `as_of`(核实日期),回答时注明,例如"据字节跳动校园招聘官网(核实于 2026-10-21)"。 - `origin: manual` 是人工从官方公众号/官网/政府平台整理的;`origin: auto` 是从岗位数据自动汇总的(`apply_end` 取该批尚未过期的最早截止日,全部过期时取最晚截止日;它不代表所有岗位同一天截止。`apply_start` 只在多数职位同一天上架时才给,否则为 `null`——单条上架日是补录日,不是开放日)。 - 高校公告的「过期时间」「已过期」只表示展示期限,不能据此断定企业截止投递。已撤回的日期不能从 `notes` 里的历史链接再补回来。 - `deadline_scope: job_evidence` 的日期来自岗位样本,不能说成整个批次截止;这类条目不会仅因某个岗位截止就整批隐藏,`window_status: unknown` 时仍需到原页确认。 - 字段为 `null` 表示来源没写,**不要补全或推测**(例如不要根据往年推测今年截止日期)。 - `open_on` 的总数包含未知窗口候选,不能直接称为“今天可投N个批次”。读取 `window_counts` 和 `hints`,计数仅代表返回页。只看明确完整批次窗口时使用 `confirmed_open_only=true`,但日期窗口也不保证实时投递成功。 - `jd_status: linked` → 可以接着用 `jobradar search --company <jd_company>` 列出具体岗位与 JD。 - `jd_status: blocked` → 只给日历信息,并**把 `hint` 原样放在回答最后一句**(如"拼多多希望你去他们的招聘页逛一逛哦~"),附 `apply_url`。 - **城市和网申时间不是每条都有**:`--city` / `--deadline-before` 只命中写了该字段的条目(当前覆盖率从 `doctor` / `stats` 查询,不能套用固定百分比)。所以 「`--city 拉萨` 返回 0 条」**不等于**"拉萨没有校招",正确说法是"日历里没有写拉萨的条目,可以去掉城市再看该公司全部批次"。 返回里的 `hint`(或 MCP 返回的 `advice`)已经说明了这一点,**照它说,不要自己改写成"没有岗位"**。 同理 `--deadline-before` 返回空只能说明"没有写了截止日且落在该范围内的条目",不能说"没有快截止的岗位"。 - `--has-window` 的口径是**起止任一有值**:只有截止日、没写开始日的批次也算"有网申时间",回答时说"截止 X 月 X 日"即可,不要说"没有网申时间"。 - `project_type: 社招` 的条目来自社招板(一家几千条),没有届次也没有批次窗口,**不要当校招批次讲**。 - 一条日历 = 一个批次(秋招正式批 / 暑期实习 / 社招…),不是一条 = 一个岗位。想知道具体岗位,用 `search --company`。 8. **资格与待遇需要原文**:先读 `field_warnings` 和 `qualification_evidence`;学历字段与正文冲突时不得只按字段排除。社招渠道也可能接受应届或毕业不久人群,不能把渠道标签当作资格。薪资、出勤天数和实习月数仅引用正文或明确标注;未提供则未知。校招不代表不要求经验,正文提到英语不代表英语是硬性门槛。投递简历、内推和面试评价超出本工具范围。 ## 输出建议 - 岗位多时先给数量和分布(按城市/职类),再列最相关的 5–10 个。 - 列表格式:`公司 | 岗位名称 | 城市 | 类型/届别 | 链接`。 更多示例见 `references/examples.md`。skill/jobradar/references/candidate-workflow.md4.6 KBfb9d52104e89upstream ↗
# 个人求职条件与连续追问 ## 条件变更 每次查询前核对当前的公司、城市、招聘类型、届次、岗位方向和截止范围。 用户明确修改一项时替换旧值,保留其他仍然有效的条件;不把旧城市或旧届次继续带入。 “第二个”“刚才那三个”对应上次实际展示的岗位ID,不能重新搜索后按新排序取同一序号。 切换到另一个求职者时,不沿用前一个人的身份条件。 “明年毕业”“今年毕业”按本次北京时间换算;海外毕业月份、实习还是全职等决定资格但未说清时, 先澄清关键歧义。毕业年份命中不等于满足全部资格,仍需检查专业、经验与原文要求。 ## 多城市与排除项 用户接受多个城市时用 `cities` 数组取并集(CLI为 `--cities`),不同时传旧的 `city`。 `exclude_cities` 排除记录列出的任一禁选城市,包含可选与禁选城市的多城市岗位也会整条排除。 未知城市仍未知,不能说已确认工作地符合。多个独立查询仍须按岗位ID合并,不能直接相加总数。 “优先北京,没有再看天津”按优先顺序检索,不把两个城市混成同级推荐。 公司总部和岗位工作地点分别解释,不从总部推断地点。 `exclude_companies` 按确定主体排除,歧义名称必须先澄清;未匹配主体时不能声称排除成功。 `exclude_keywords` 只排除标题字面量,不能表达“不要求英语”“非芯片软件岗”等完整语义。 这些语义条件仍需对实际结果逐条核对。筛选后不足需要继续取样时明确说明, 不把单页排除后数量说成全库数量,也不把未展示的结果当作已检查。 ## 必须读取原文的要求 薪资、工作经验、实习天数/时长、到岗日、转正、远程、出差和证书没有统一的结构化筛选。 可用标题或正文检索找线索,再读取详情核对;词语出现不等于条件成立, 例如“远程”可能出现在“不支持远程”,“经验”也可能出现在“经验不限”。 区分必需、优先、可协商和未知,不把“优先”写成硬性门槛。 最低学历只能提供部分信息,不能代替专业、在校身份等要求;空值不等于不限。 `qualification_evidence.degree.conflict=true` 时并列说明已存学历字段和正文候选要求; 正文提取只是定位证据,不能覆盖原字段或代替资格确认,必须注明其观测时间。 薪资未公开时保留未知,不根据公司、职级或市场行情补值。 正文的 `text_observed_at` 与岗位的 `last_seen` 分开说明,旧正文不能当成本次刚核实。 ## 筛选过窄与推荐 保留用户原条件的结果;放宽城市、届次、类型或公司后的结果属于另一个范围,单独标明差异。 用于了解缺失字段的补充查询不能自动成为“符合要求”的推荐。 未经确认,不用往届、其他城市、社招或无明确届次的记录填满清单。 CLI与MCP默认折叠同公司、标题、城市、招聘类型、届次、学历、部门、批次和截止日相同的记录。 `count_unit=folded_groups` 是展示分组,`variants` 是组内记录数,不能称为独立机会数量。 同组职责仍可能不同;需要完整逐条核验或事件统计时设 `dedupe=false`(CLI为 `--no-dedupe`)。 职类词不匹配时读 `category_match.available`;财务/会计映射到具体财务审计,不能默认放宽到全部职能。 选择“最适合”“最值得投”的岗位时说明比较维度,逐项对应已知条件及原文依据, 同时列出尚未确认的要求。不把先出现、公司名气或关键词命中当作资格保证。 展示数量、实际核对数量与全部匹配数量分别表述。 ## 时间与投递入口 临近截止的比较使用明确的 `apply_end`,优先展示更早的日期;未知截止日单列,不能混入日期范围。 最近新发现时间不等于企业发布日期。截止当天保留不意味着当前时刻一定可投, 没有具体时刻或原页确认时说明仅有日期证据。 岗位来源为招聘公告时,原链接可能先到学校或其他公告页;说明这是信息来源, 只在明确找到雇主申请入口后将其称为直接投递链接。 `url_scope=project_listing` 需要到项目列表按标题查找;若返回 `recorded_url`,它是保留的历史链接, 优先展示修正后的 `url` 并说明列表作用域,不能称为直达该岗位的申请页。 日历的 `company` 或 `product` 可以是子品牌或招聘项目,查询项目名称时使用公司/产品范围, 不要强行同时要求集团同名。skill/jobradar/references/examples.md1.6 KBc08f56d46742upstream ↗
# 示例 ## "腾讯这周新开了什么岗?" ```bash jobradar diff --days 7 --company 腾讯 --types open --limit 100 ``` 回答要点:数据截至时间;新开数量;按职类/城市归纳;列出代表性岗位及链接。若 `results` 为空,先用 `jobradar search --company 腾讯 --limit 1` 查看 `company_match` 与 `empty_reason`,区分未收录、无当前岗位和本次筛选无匹配。 ## "阿里和字节的算法岗要求有什么差异?" ```bash jobradar compare 阿里巴巴 字节跳动 --category 算法 --per-company 8 ``` 回答结构: 1. 样本说明:每家取了几个岗位、数据截至何时。 2. 共同要求(引用原文关键词)。 3. 差异:分点列出,每点注明"阿里 JD 原文:……" / "字节 JD 原文:……"。 4. 你的归纳(明确标注为归纳),以及样本有限的提醒。 ## "某某科技在招什么?"(库里没有) 只有 `company_match.match=none` 才说明该名称未收录;匹配为 exact/alias/contains 但结果为空,只能说明当前筛选无匹配。`compare` 的 `missing_companies`、`no_matching_jobs` 与 `ambiguous_companies` 分别解释,不能仅凭 `not_found` 判断未收录。 列表里的 `returned` 是返回条数,`total` 是本次筛选总记录数;`truncated=true` 表示只返回了样本,不能把样本数当总数。 ## 严格比较同一城市、届次和招聘类型 ```bash jobradar compare 腾讯 京东 --category 算法 --city 深圳 --type campus --grad-year 2027 --per-company 3 ``` 所有条件同时生效;严格结果为空时不能拿放宽条件的记录冒充符合要求。skill/jobradar/references/fields.md11 KB97f96cfca089upstream ↗
# 字段说明 所有查询输出都是: ```json {"data_as_of": "2026-10-20T03:00:00Z", "stale": false, "...": "...", "results": [...]} ``` - `data_as_of`:最近一次成功抓取的时间(UTC)。回答时换算成北京时间更友好(+8 小时)。 - `stale`:全局数据超过48小时未更新,或本次返回岗位包含超过48小时未确认的来源或岗位观测;来源新鲜不能覆盖岗位自身的陈旧。 - `snapshot_stale`:只判断全局快照是否超过48小时;为`false`而`stale`为`true`时,应核实陈旧岗位的原始链接,不把重复下载同一快照作为恢复证据。 - 岗位的 `source_last_ok` / `source_age_hours` / `source_stale`:对应来源最近成功时间、距今小时数及是否过期;`availability` 区分已下架、已到期、旧来源尚未确认及最近观测,不能作为实时可投保证。 - `last_seen` / `job_age_hours` / `job_stale`:岗位自身最近观测、距今小时数及是否超过48小时。`not_seen_in_latest_success=true`表示最近成功采集中没有再次见到该岗位;`availability=unconfirmed_not_seen`仍保留历史记录,不能直接推定关闭或保证可投。`availability_counts`只汇总返回页;对比时为各家公司返回列表合计,不等于全库分布。 - `text_observed_at`:详情、对比及全文检索所附正文的实际观测时间;为空时不能从 `last_seen` 补成新读正文。按截止日筛选的岗位优先返回更早的明确截止日;不传日期范围时保持最近发现优先。 - `source_enabled`:客户端来源目录中的启用状态,未知为 `null`;`false` 对应 `availability: unconfirmed_disabled`,旧成功记录不能覆盖停用状态。已下架或已到期仍优先显示相应状态。 - `availability_label` / `source_warnings`:中文状态及历史来源限制;`source_tenant_peers`非空表示配置中同一租户还登记在其他来源下,不能将来源数量直接相加。 - `frontline_filter`:校招/实习查询的一线岗位标题过滤模式、排除记录数和计数范围;不修改岗位状态,全文检索未复算数量时为`null`。`include_frontline=true`可主动包含,`exclude_categories`按固定职类字段排除;对比的`company_filters`逐公司返回说明。 ## 招聘公告记录 `source_id` 以 `jysd-` 开头的是高校公开招聘公告,属于聚合来源。一条记录可能包含多个岗位,不能把记录数说成单岗数或招聘人数;`company` 保留实际登记主体全名,分公司范围不代表集团全量招聘。标题和正文仍需附原始学校来源链接。 学校的公告过期时间与雇主网申截止日不同,只有明示、唯一的报名截止日才写入 `apply_end`。公告在来源中过期或不可见,不等于该公司所有招聘都结束。城市、学历或截止日缺失时按空值解释。 ## 空值怎么理解(很重要,别把"没抓到"说成"没有") | 字段 | 空值含义 | 覆盖口径 | |---|---|---| | `cities` | 来源未提供可靠工作地 | 本次 `stats.jobs.fields.cities`;校招单列 `campus_cities` | | `grad_year` | 来源没有唯一可靠届次;多届、范围或否定也可能留空 | 本次 `stats.jobs.fields.grad_year`;校招单列 `campus_grad_year` | | `category` | 标题规则未能归类 | 本次 `stats.jobs.fields.category`;不等于没有相关岗位 | | `batch` | 来源没区分批次 | 常见于社招与部分校招 | | `degree_min` | 未得到四档内的可靠学历值,或平台只写不限/更低学历 | 本次 `stats.jobs.fields.degree_min`;有值也需检查正文冲突 | `degree_min` 的取值只有四档:`大专` / `本科` / `硕士` / `博士`(2026-10-29 起统一)。 平台原值("本科及以上""硕士研究生""中技(中专/技校/职高)"等 26 种写法)在入库时已经归一; 低于大专的学历(高中/中专/初中/小学)与"不限"记为空。 回答时的正确姿势: - 用户问"北京有哪些岗"时,先说明"部分来源不提供城市,结果可能不全",再给结果; - 不要因为 `cities` 为空就断言"该岗位不在北京"——它可能只是来源没写; - 同理,`grad_year` 为空不等于"不限届别"; - `degree_min` 为空不等于"不限学历",只表示"没抓到可信的学历要求"。 ## 招聘日历(calendar 的元素) | 字段 | 含义 | |---|---| | `group_name` | 集团名(与 `targets/top_companies.yaml` 一致) | | `company` / `product` | 具体公司/产品线,可能为空 | | `project_type` | 提前批/秋招正式批/春招/暑期实习/日常实习/校招/社招… | | `apply_start` / `apply_end` | 网申起止(来源写明才填,否则为空) | | `deadline_scope` | `batch` 批次截止 / `job_evidence` 岗位样本日期(不代表整批截止)/ `unknown` 截止日未知 | | `field_evidence` | 城市、届次、起止日期各自的来源与作用域;补城市不覆盖原截止日证据。旧快照缺少字段证据时按旧来源保守解释 | | `cities` | 工作城市(同上) | | `apply_url` | 投递入口(官方招聘站) | | `jd_status` | `linked`(数据层有 JD)/ `official_page`(有公开 JD 页)/ `blocked`(被挡,只给日历)/ `none` | | `hint` | `blocked` 时给用户的引导语,回答时**原样**放在最后一句 | | `source` | `{type, name, url, date}`:官方公众号 / 官网 / 政府平台;第三方日历不采 | | `origin` | `manual` 人工从官方渠道整理 / `auto` 由岗位数据自动生成 | | `tracks` | 方向(track 级):`[{direction, roles}]`,roles 是具体岗位名,可能为空 | | `open_jobs` | 仅 `auto` 条目:与默认搜索一致,排除已下架及明确截止日已过的岗位;不等于当前实时可投数量 | | `window_status` / `window_counts` | 指定日期下的完整批次日期窗口或未知;汇总的scope=returned仅指返回页,不等于实时可投数量 | | `observed_from` / `observed_to` | 仅 `auto` 条目:数据里首次/最近一次看到在招的日期(不是网申起止) | | `as_of` | 这条信息人工核实/自动生成的日期 | | 字段 | 含义 | |---|---| | `id` | 岗位唯一 id,`show` 用它 | | `company` | 公司名 | | `title` | 岗位名称或招聘公告标题(原文) | | `url` | 可用来源入口;已审核的旧失效路径改为列表入口时另保留 `recorded_url` | | `recruit_type` | `campus` 校招 / `intern` 实习 / `social` 社招渠道;不等于完整投递资格 | | `grad_year` | 届别,如 2027;来自明确的平台字段、标题或适配器已经核验的正文规则,不使用通用 JD 规则回填;无法确定则为空 | | `batch` | 批次,如 提前批/正式批/补录;可能为空 | | `cities` | 工作城市列表("北京市-海淀区"归一为"北京");来源未提供时,取标题中被分隔符明确隔开的城市名(如"-深圳-""(武汉)"),否则为空 | | `category` / `subcategory` | 职类(归一化后);可能为空,此时以 `title` 判断 | | `degree_min` | 最低学历要求;可能为空 | | `department` | 部门/事业群 | | `first_seen` | 数据中第一次观测的时间,不代表企业首次发布时间 | | `last_seen` | 来源列表最近一次看到记录的时间;是否可投还需结合截止日与下架状态 | | `text_observed_at` | `show` 的正文观测批次时间;复用原文时保留旧值,不等于列表刷新时间 | | `closed_at` | 已观测到的下架时间;为空只表示尚未确认下架,需结合截止日期及来源新鲜度 | | `description` / `requirements` | JD 原文(职责 / 要求);`search --text` 全文检索 | | `match` | 仅 `search --text` 返回:JD 原文中命中处的片段(只命中标题时为 null) | | `qualification_evidence` / `field_warnings` | 平台学历与正文候选证据、冲突提示和正文时间;不改原字段,不保证资格成立 | | `grad_year_match` | 传届次时区分 `explicit` 与 `unknown`,后者需另行核实 | | `url_scope` / `url_hint` | `project_listing` 为项目列表,`source_notice` 为公告,`unknown` 为未确认作用域;均不保证已完成投递 | | `variants` | 折叠组内原记录数;同组正文仍可能不同,不能等同新增机会或招聘人数 | ## 变化(diff) | 字段 | 含义 | |---|---| | `type` | `open` 新开 / `close` 下架 / `change` 内容变更 / `reopen` 重新开放 | | `ts` | 发现变化的时间 | | `diff.fields` | change 时变化的字段名;`["text"]` 表示只有 JD 原文变了 | 注意:下架判定需要岗位在连续 3 次成功抓取中都缺席,所以"下架时间"比实际下架晚 1–3 天。 `stats.jobs.jd_observation` 单独报告正文在48小时内的观测数与较早观测数,以及最早/最近的正文观测时间。岗位来源刷新不能替代正文新鲜度;详情应同时查看 `last_seen` 和 `text_observed_at`。 `diff --by category` 不返回事件流,而是聚合结果:`[{"category": "技术", "n": 120}, …]`,按新增数量降序; 没有职类的岗位归到「未分类」。用于回答"最近哪类职位新增最多"。 ## 趋势(trends) `[{"date": "2026-10-01", "open": 120}, ...]`:每个采样日的在招岗位数。最早日期 = 该公司数据开始积累的日期。 ## 职类(category / subcategory) 由 `taxonomy/categories.yaml` 按岗位标题规则归类;**没命中规则的岗位职类为空**,查询时请同时用 `--keyword` 按标题关键词搜索,不要因为某职类无结果就断言"没有这类岗位"。 `stats.jobs.category_vocabulary` 是安装包分发的固定词表,不会被平台遗留职类改变;`category_match` 说明精确、别名或未匹配,`matched`列出实际检索值。 财务/会计/审计映射到具体的财务审计,backend/frontend分别映射后端/前端,不自动扩成整个技术或职能大类。 | category | subcategory | |---|---| | 管培 | 管培生 | | 产品 | 产品经理 | | 项目管理 | 项目管理 | | 技术 | 算法、芯片/硬件、嵌入式、前端、客户端、测试、数据、运维、安全、后端、软件开发、技术支持 | | 设计 | 设计 | | 工程制造 | 汽车工程、工艺/设备、质量、机械/电气、生产 | | 运营 | 运营 | | 门店零售 | 门店运营 | | 市场销售 | 销售、市场 | | 职能 | 人力、财务审计、法务、采购供应链、行政 | | 金融 | 投研、银行柜员、保险 | | 医药 | 医药研发、临床医学、学术推广 | ## `stats` 里几个容易混淆的键 | 键 | 含义 | |---|---| | `calendar.calendar_covered` / `calendar_entries_covered` | **有日历条目**的目标公司数,以本次返回为准 | | `calendar.covered_any` | **有日历条目或有岗位数据**的目标公司数,与岗位数据源配置覆盖分别报告 | | `calendar.jd_covered` / `jd_page_covered` | 有**公开 JD 页/关联**的公司数,不是岗位比例 | | `calendar.entries` | 人工条目数 / 数据层自动条目数 | | `calendar.by_sector` | 按行业的 `targets` / `calendar_covered` / `jd_covered` | | `jobs.with_jd_text` | **岗位**里有 JD 正文的数量(与上面的「公司数」不是一个量纲) |skill/jobradar/references/setup.md3.1 KBbad9beb26beaupstream ↗
# 首次接入:由助手准备查询能力 只在首次使用、连接失败或版本不兼容时阅读。本技能查询公开招聘信息,不需要简历、招聘账号或自动投递权限。 ## 先检查所在环境 - 已连接 jobradar MCP:优先使用其工具,调用 `data_status` 检查数据;发现缺库或过旧时,在实际运行服务的环境更新。 - 支持技能和本地命令执行:检查 Python 3.11+、可用磁盘和下载网络,再在独立环境安装;遵守当前平台的安装与权限提示。 - 只能网页聊天、阅读附件,或只接受远程 MCP URL:说明当前模式缺少执行入口,引导用户查看[平台选择](https://github.com/lijiaqi-AI-Product-Manager/job_radar/blob/main/docs/PLATFORMS.md)。本项目没有运营中的公共 HTTP MCP 地址,不编造地址,也不把 GitHub 仓库链接当服务地址。 未实际调用成功前,不回答“已接入”。需要用户做界面操作时,只给当前这一步以及成功标志,不一次倾倒全部命令和配置。 ## 安装并下载数据 在将实际运行查询的 Python 环境中执行: ```bash python -m pip install --upgrade "jobsearchradar[mcp]" jobradar --version jobradar update jobradar doctor ``` 首次更新下载岗位、JD 正文和日历三库,体积随快照变化,检查足够的下载和解压空间。默认使用 GitHub;镜像当前状态见[安装渠道](https://github.com/lijiaqi-AI-Product-Manager/job_radar/blob/main/docs/DISTRIBUTION.md)。已有有效数据时,下载失败保留旧快照,但需说明旧数据时间。 有执行能力时由助手运行,再用自然语言解释结果。没有该能力时如实说明并提供兼容客户端的接入路径。 ## 两种查询入口任选其一 **技能 + 本地工具:** 按 `SKILL.md` 调用 `jobradar`,读取 JSON;不必为此额外配置 MCP。 **本地 MCP:** 在客户端添加 stdio 服务。常见结构如下,实际字段以客户端官方设置为准: ```json { "mcpServers": { "jobradar": { "command": "jobradar-mcp" } } } ``` 客户端找不到命令时,将 `command` 替换为安装环境中可执行文件的绝对路径;Windows JSON 路径的反斜杠写成 `\\`。自定义数据目录时,在服务 `env` 中设置同一 `JOBRADAR_HOME`。仅添加 MCP 不会自动下载数据。 ## 确认可以使用 1. 读取数据状态,确认库存在,记录 `data_as_of`;过旧按技能规则处理。 2. 按用户原始条件实际查询少量候选;MCP 应能列出搜索、详情、日历等九个工具。 3. 回答候选、原始链接、数据时间与未知条件。没有结果也返回真实查询说明,不虚构成功样本。 之后用户可以直接说“换成深圳”“排除上海”“先看这周截止的”。保留未被修改的条件,精细资格需读原文,放宽后的候选单列。 安装故障与固定源码备用路径见[安装指南](https://github.com/lijiaqi-AI-Product-Manager/job_radar/blob/main/docs/INSTALLATION.md)。技能压缩包不含数据库,不能仅靠上传文件实现无工具查询。README.mdupstream ↗
Contents are not inlined in the catalog. Open the upstream file.
Plain-text copy, no login: /skill-bundles/lijiaqi-ai-product-manager-job-radar-skill-jobradar.md